Agentic RL
约 5732 个字 11 行代码 5 张图片 预计阅读时间 19 分钟
Slowist 2026/11
一、Reinforcement Learning
概念
强化学习(Reinforcement learning,RL)讨论的问题是一个智能体(agent) 怎么在一个复杂不确定的 环境(environment) 里面去极大化它能获得的奖励。通过感知所处环境的 状态(state) 对 动作(action) 的 反应(reward), 来指导更好的动作,从而获得最大的 收益(return),这被称为在交互中学习,这样的学习方法就被称作强化学习。
为了建模这样一个系统,我们需要(对着上面这段又臭又长的话)做以下定义:
- \(s\): state,智能体所处状态
- \(a\): action, 智能体所采取的动作
- \(V(s)\):value of state,状态价值,衡量一个状态有多好
- \(Q(s,a)\):Quality of action in the state, 动作价值,衡量在某状态下执行某动作有多好
- \(\pi(a|s)\):策略,在某状态下采取什么动作
- 这个实际上是概率,\(\pi(a|s)=P(A_t=a|S_t=s)\)
强化学习通常通过 \(V\) 或 \(Q\) 评价策略,再利用评价结果改进 \(\pi\)。
Bellman 方程
考虑一个马尔可夫决策过程(MDP),在时刻 \(t\) 智能体在状态 \(s_t\) 下选择动作 \(a_t\) ,环境给出奖励 \(r_t\) 并转移到 \(s_{t+1}\) 。(出于长期回报不如当下回报的朴素认知,以及对于 \(G_t\) 能够收敛的朴素憧憬),定义折扣收益 \(G_t\):
由此我们可以定义给定一个策略 \(\pi\) 的状态价值和动作价值:
- \(V^\pi(s)=\mathbb{E}_\pi[G_t \mid S_t=s]\)
- \(Q^\pi(s,a)=\mathbb{E}_\pi[G_t \mid S_t=s,A_t=a]\)
对于给定策略 \(\pi\),状态价值满足 Bellman 期望方程;
这个方程提供的思路是可以把当前状态的价值拆解为即时奖励与下一状态的价值。
如果知道环境转移概率 \(P(s'∣s,a)\) 和奖励函数 \(r(s,a,s')\),可以迭代:
但实际上,我们通常不知道环境转移概率 \(P(s'∣s,a)\)。那应该怎么办呢?
Monte Carlo (蒙特卡洛)
MC 基于大数定律的想法,直接采样某条轨迹结束后计算实际回报:\(G_t = r_t + \gamma r_{t+1} + \dots\)
用实际的\(G_t\)更新:\(V(s_t) \leftarrow V(s_t) + \alpha\big[G_t - V(s_t)\big]\)
MC的缺点是必须等到轨迹结束才能获得完整回报,对于回合很长的任务,这种训练方式效率较低。
Temporal Difference(时序差分)
为了不要这么长,人们又提出了一种叫 TD 的方法,观察 \(G_t\) ,可以知道
也就是:
利用实际上 \(V(s_{t+1})= \mathbb E[G_{t+1}|s_{t+1}]\) , 可以把目标替换为
另外,定义 TD Error(时序差分误差):
TD(0) 的更新为
Policy Gradient(策略梯度):直接优化策略
我们希望能用一个带参数 \(\theta\) 的函数(通常是神经网络),来直接表示策略 \(\pi(a|s)=P(A=a|S=s)\),输入状态 \(s\), 输出在 \(s\) 下各个动作的概率分布。
定义以下:
- \(\tau\):一条完整轨迹 \((s_0,a_0,r_0,s_1,a_1,r_1,\dots)\)
- \(\tau \sim \pi_\theta\):这条轨迹是用当前参数为 \(\theta\) 的策略 \(\pi_\theta\) 采样出来的
- \(R(\tau)\):这条轨迹总的折扣回报,也就是 \(G_0\)(从轨迹起点开始的折扣回报)
- 其优化目标函数为: \(J(\theta)=\mathbb E_{\tau\sim \pi_\theta}[R(\tau)]\)
对这个优化问题梯度下降求解:
因此可以通过最小化 \(-\mathbb{E}\big[\log\pi_\theta(a_t|s_t) G_t\big]\) 实现梯度上升。
上述 \(\nabla_\theta J(\theta)= \mathbb{E}\Big[\nabla_\theta\log\pi_\theta(a_t|s_t)\; G_t\Big]\) 的推导
轨迹 \(\tau = (s_0,a_0,r_0,s_1,a_1,r_1,\dots,s_T,a_T)\)
轨迹的概率:
\(p_\theta(\tau)=p(s_0)\prod_{t=0}^{T-1}\pi_\theta(a_t|s_t)p(s_{t+1}|s_t,a_t)\)
其中:
\(p(s_0)\):初始状态分布,和 \(\theta\) 无关
\(p(s_{t+1}|s_t,a_t)\):环境转移概率,环境固定,和 \(\theta\) 无关
只有 \(\pi_\theta(a_t|s_t)\) 是策略,带参数 \(\theta\)
又∵ \(J(\theta)=\mathbb{E}_{\tau\sim p_\theta(\tau)}[R(\tau)],\quad R(\tau)=\sum_{t=0}^T \gamma^t r_t = \nabla_\theta J(\theta)=\nabla_\theta \int p_\theta(\tau) R(\tau) d\tau\),
\(\therefore \nabla_\theta J(\theta)=\nabla_\theta \int p_\theta(\tau) R(\tau) d\tau = \nabla_\theta J(\theta)=\int \nabla_\theta p_\theta(\tau)\cdot R(\tau) d\tau\)
我们不知道 \(\nabla_\theta p_\theta(\tau)\) 长啥样,用对数求导技巧:
\(\nabla_\theta p_\theta(\tau)
= p_\theta(\tau)\cdot \frac{\nabla_\theta p_\theta(\tau)}{p_\theta(\tau)}
= p_\theta(\tau)\cdot \nabla_\theta \log p_\theta(\tau)\)
代入:
\(\nabla_\theta J(\theta)=\int p_\theta(\tau)\cdot \nabla_\theta\log p_\theta(\tau)\cdot R(\tau) d\tau
=\mathbb{E}_{\tau\sim p_\theta}\Big[\nabla_\theta\log p_\theta(\tau)\cdot R(\tau)\Big]\)
下面就是展开 \(\log p_{\theta}({\tau})\):
\(\because p_\theta(\tau) = p(s_0)\prod_{t=0}^{T-1}\Big[\pi_\theta(a_t\mid s_t)\; p(s_{t+1}\mid s_t,a_t)\Big]\)
\(\log p_\theta(\tau)=\log p(s_0)+\sum_{t=0}^{T-1}\big[\log\pi_\theta(a_t|s_t)+\log p(s_{t+1}|s_t,a_t)\big]\)
对 \(\theta\) 求梯度:
\(\log p(s_0)\)、\(\log p(s_{t+1}|s_t,a_t)\) 不含 \(\theta\),梯度 = 0
\(\nabla_\theta \log p_\theta(\tau)=\sum_{t=0}^{T-1}\nabla_\theta\log\pi_\theta(a_t|s_t)\)
代回梯度式子:
\(\nabla_\theta J(\theta)=\mathbb{E}_{\tau}\left[\left(\sum_{t=0}^{T-1}\nabla_\theta\log\pi_\theta(a_t|s_t)\right)\cdot R(\tau)\right]\)
交换求和和期望:
\(\nabla_\theta J(\theta)=\sum_{t=0}^{T-1}\mathbb{E}_{\tau}\Big[\nabla_\theta\log\pi_\theta(a_t|s_t)\cdot R(\tau)\Big]\)
最后把总回报 \(R(\tau)\) 换成 \(G_t\):
\(R(\tau)=\sum_{k=0}^T\gamma^k r_k\), \(G_t=\sum_{k=t}^{T}\gamma^{k-t} r_k\)。\(R(\tau)\) 是整条轨迹从 0 时刻开始的回报,\(G_t\) 是从 \(t\) 时刻开始的回报。
\(\because \nabla_\theta\log\pi_\theta(a_t|s_t)\) 只和 t 时刻的 \((s_t,a_t)\) 以及之后的轨迹有关;\(r_0,\dots,r_{t-1}\) 是 t 时刻之前拿到的奖励,和 \(a_t\) 采样无关,这一项期望等于 0,
\(\therefore \mathbb{E}\Big[\nabla_\theta\log\pi_\theta(a_t|s_t)\cdot R(\tau)\Big] =\mathbb{E}\Big[\nabla_\theta\log\pi_\theta(a_t|s_t)\cdot G_t\Big]\)
因此最后,有
\(\nabla_\theta J(\theta)=\sum_{t=0}^{T-1}\mathbb{E}\Big[\nabla_\theta\log\pi_\theta(a_t|s_t)\;G_t\Big] = \mathbb{E}\Big[\nabla_\theta\log\pi_\theta(a_t|s_t)\; G_t\Big]\)
Baseline & Advantage
为了只保留动作相对好坏的信号,引入 Baseline:
这里的 \(b(s_t)\) 相当于一个当前状态下的一般表现,只能依赖状态 \(s_t\),与动作 \(a_t\) 无关。这么操作之后梯度期望不变。
梯度不变的推导
\(\mathbb{E}\big[\nabla\log\pi \cdot (G - b)\big] =\mathbb{E}\big[\nabla\log\pi \cdot G\big] - \mathbb{E}\big[\nabla\log\pi \cdot b(s)\big]\)
对于第二项,由于
\(\mathbb{E}_{a\sim\pi(\cdot|s)}\Big[\nabla_\theta\log\pi_\theta(a|s)\cdot b(s)\Big] = b(s)\cdot \mathbb{E}_{a\sim\pi(\cdot|s)}\big[\nabla_\theta\log\pi_\theta(a|s)\big]\)
接下来证明:
\(\mathbb{E}_{a\sim\pi(\cdot|s)}\big[\nabla_\theta \log\pi_\theta(a|s)\big] = 0\)
先证明一个链式法则:\(\pi \cdot \nabla\log\pi = \nabla\pi\)
直接对 \(\log\pi\) 求导,链式法则:
\(\frac{d}{d\theta}\log\pi(\theta) = \frac{1}{\pi(\theta)}\cdot \frac{d\pi(\theta)}{d\theta}\)
移项:\(\pi \cdot \nabla_\theta \log\pi = \nabla_\theta \pi\)
因此,展开期望:
\(\mathbb{E}_{a\sim\pi}\big[\nabla_\theta\log\pi(a|s)\big] =\sum_a \pi(a|s)\cdot \nabla_\theta \log\pi(a|s) = \sum_a \nabla_\theta \pi(a|s) = \nabla_\theta \sum_a \pi(a|s)\)
概率分布,\(\sum_a \pi(a|s)=1\),所以上述梯度为0.
对于这个 Baseline,一个常见的选择是令 \(b(s_t)=V^{\pi}(s_t)\)。由 \(Q^\pi(s,a) = \mathbb{E}[G_t \mid s_t=s,a_t=a]\),我们可以定义一个优势 Advantage,来衡量相对于当前状态下平均表现的好坏:
Actor-Critic
回顾上面的梯度下降的公式,因为 \(\mathbb{E}\big[\nabla_\theta\log\pi_\theta(a_t|s_t) G_t\big]\) 仍然依赖 \(G_t\),面临了我们之前说的和蒙特卡洛(MC)一样的问题。因此我们采取之前了类似TD的问题解决,转换为一步转移的问题。
因此可以近似:
其中 \(\delta_t\) 恰好是我们在 TD 里定义过的误差。
由上面这个式子可以知道,如果我们想训练 \(\pi\),必须知道 \(V(s_i)\) 的值。因此价值 \(V\) 和策略 \(\pi\) 需要同时训练,即所谓的 Actor-Critic 框架。
- Actor:训练策略 \(\pi_{\theta}\)。其中 Loss 即 \(L_{\text{Actor}} = -\mathbb{E}\big[\log\pi_\theta(a_t|s_t)\cdot \text{sg}(\hat A_t)\big]\)
- sg: stop gradient. 冻结 \(A_t\),不做梯度回传。
- Critic:训练价值 \(V\), Loss 即为 TD 损失,\(L_{\text{Critic}}=\mathbb{E}\Big[\big(V_\phi(s_t)-\big[r_t+\gamma V_\phi(s_{t+1})\big]\big)^2\Big]\)
PPO
由于Actor-Critic的两个网络是分别更新的,如果其中一个更新过大,另一个的更新可能会失效(因为沿用了旧的数据),所以需要防止策略更新太大。
PPO 解决了策略更新太大的问题,它设定 \(r_t(\theta) = \frac{\pi_\theta(a_t|s_t)}{\pi_{\theta_{\text{old}}}(a_t|s_t)}\). \(r_t>1\) 说明新策略想提高这个动作概率,反之是想压低动作概率。
因此目标函数定义为:
其中 \(\epsilon\) 不会很大,通常取 0.2。
这个定义的作用如下:
- 如果优势 \(\hat A>0\)(动作很好):我们想提高动作概率,但最多只允许把概率放大到原来的 \(1+\epsilon\) 倍,不允许无限拉高;
- 如果优势 \(\hat A<0\)(动作很差):我们想降低动作概率,但最多只允许压到原来的 \(1-\epsilon\) 倍;
由此来保证新策略和采样用的旧策略不会差太远,提升了稳定性。
为什么已经里面有clip函数了,还要min?
拿个例子分类讨论一下:
- 如果 \(r > 1+\epsilon\),\(\text{clip}(r)=1+\epsilon\):
- 当 \(\hat A_t > 0\) 时,我们希望增大 \(r\),于是 \(r\hat A > (1+\epsilon)\hat A\),\(\min\) 取 \((1+\epsilon)\hat A\)。此时这一项变成常数,对 r 的梯度 = 0,不再继续拉高这个动作概率
- 当 \(\hat A_t < 0\) 时,我们希望减小 \(r\),\(\hat A<0\).
- \(A\) 是负的,\(r\) 跑到上限外面不是危险的 “过度拉高”,反而是 \(r\) 太大(坏动作概率太高),我们需要把它压回去
- 乘以更大的数会更小:\(r\hat A < (1+\epsilon)\hat A\),这里应该取原始的 \(r\hat A_t\), 所以要 \(\min\).
GRPO
我们之前说过 Baseline 的一个常见选择是 \(b(s_t)=V^{\pi}(s_t)\),但因此会像上述 PPO 那样需要同时训练 Actor 和 Critic 两个网络。因此,GRPO 把 baseline 换成独立采样一些轨迹之后的平均值。
假设一共采样 \(G\) 条轨迹,定义经验 Baseline:
这个 \(\hat b(s)\) 是 \(V(s)=\mathbb{E}[G|s]\) 的无偏样本估计:\(\mathbb{E}[\hat b(s)] = V(s)\)。
因此同样的,对第 \(i\) 条轨迹,构造优势:
- 其中 \(\sigma_G\) 就是这个条件方差的样本估计:\(\sigma_G = \sqrt{\frac1G\sum_{i=1}^G (G_i-\hat b(s))^2}\)
之后,使用和 PPO 完全一致的 clip 保守代理目标做策略更新:
- 其中\(\rho_{i,t}=\frac{\pi_\theta(a_t|s_t)}{\pi_{\text{old}}(a_t|s_t)}\) 是新旧策略比率。
强化学习的更新框架
传统的RLHF使用的PPO,有actor/critic/reward/ref四个模块,按照如图所示的工作流迭代模型。下图出自HybridFlow论文的rlhf流程图。
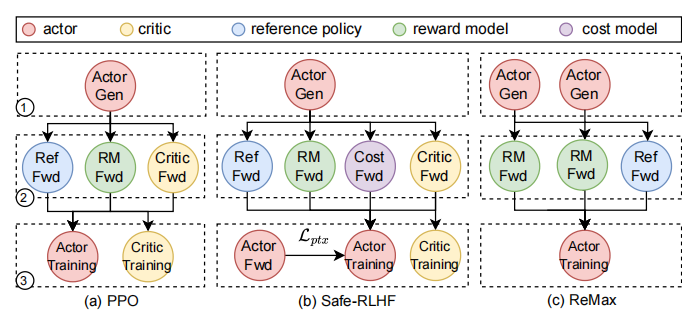
参考HybridFlow论文中伪代码的写法,用batch指代过程中所有变量组成的dict。
for prompts in dataloader:
    # Stage 1: response生成
    batch = actor.generate_sequences(prompts)
    # Stage 2: 训练数据准备
    batch = critic.compute_values(batch)
    batch = reference.compute_log_prob(batch)
    batch = reward.compute_reward(batch)
    batch = compute_advantages(batch)
    # Stage 3: actor和critic训练
    critic_metrics = critic.update_critic(batch)
    actor_metrics = actor.update_actor(batch)
上述过程中参数迭代只发生在 stage 3,前两个过程都属于模型推理。针对这些过程,(据说)最耗时间是 stage 1,因为和环境的交互通常比较慢;涉及 LLM 则需要多轮的 Decoding, 而对于 agent 而言甚至每一轮可能都还要调用工具。
通常的加速方法上和 LLM Inference 的加速是类似的,例如 Parallel, Speculative Decoding, KVCache, 量化等。量化上,通常是Actor 侧量化,训练保持高精度。对于一些常见的方法,通常通过接 vllm/sglang 这样的推理框架来做,目前这些推理框架都已经适配一些主流的 RL 框架。
通常和LLM Inference类似的,有一套框架(主流的例如verl)能够接入各种RL的方式,进行训练。另外,在系统上通常将还会Actor 推理集群 和 Trainer 训练集群分离来对系统进行加速。
RLVR:Reinforcement Learning with Verifiable Rewards
上述我们讨论的都属于 RLHF, 即 Reinforcement Learning with Human Feedback。RLVR的概念由 Nathan Lambert 在Tulu3项目中提出,见2024年发表的论文《Tulu 3: 推动开放语言模型后训练的前沿》(Tulu 3 Paper)。有意思的是,灵感来源于 DeepSeek Math/R1 的研究,也就是说,Deepseek 在没有 RLVR 这个概念的情况下已经用上这个方法了。
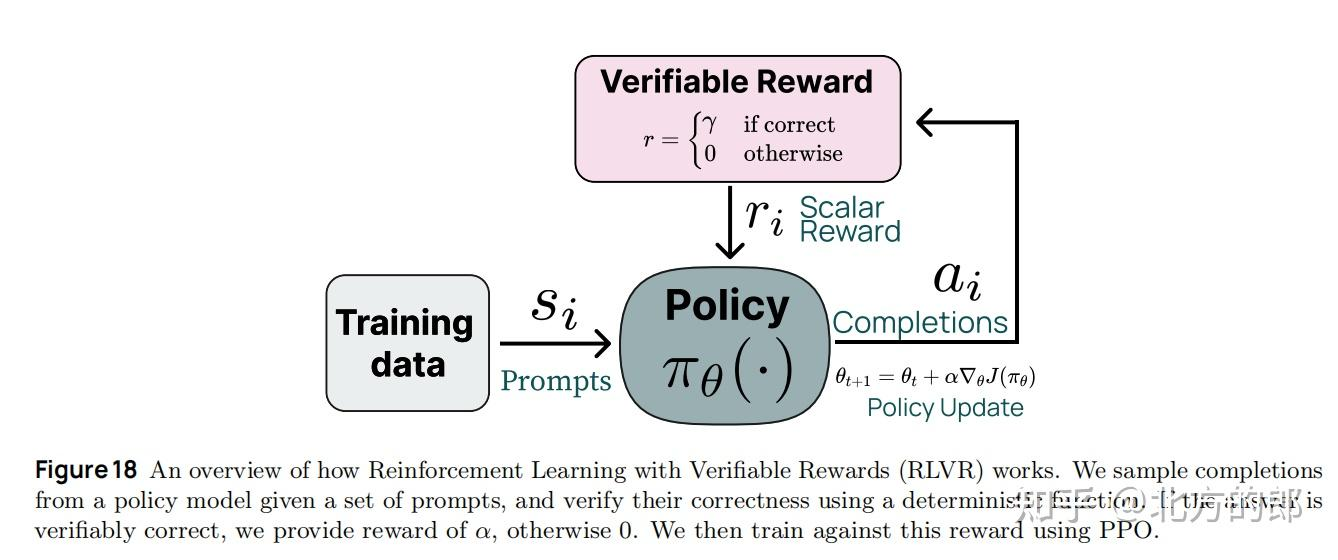
相比我们上面的过程,RLVR 的核心不同之处在于引入了一个 Verifier,通过确定性规则自动评估模型输出的正确性,提供二元奖励信号。
具体过程包括:
- 数据收集与整理: 收集一个带标准答案的数据集。比如著名的 GSM8K,包含了很多小学数学应用题和答案。
(小学二年级知识真是有用) - 设计自动打分规则: 比如答案对了=1分,错了=0分。
- 奖励模型验证: 验证上面的自动打分有没有bug。
- 放进RL的Pipeline里,大功告成!
上述的 Reward 信号还是基于规则的。随着 RL 的发展,现在出现了越来越多的奖励信号的设计,比如 这篇知乎回答。
思考 1
这么做真的有用吗? 有论文质疑了这一点,Yue 等人 (2025) 认为,当你把采样次数拉大时,base model 的 Pass@K 会追平甚至超过 RL 后的模型。因此,他们认为 Base 模型参数里面,本来就已经存在正确的推理路径,只是这条路径的概率很低。RLVR 没有教会模型新的推理方式,它只是调整了输出分布:拉高了这条本来就存在的正确轨迹的采样概率,压低错的轨迹概率。这样的话,RLVR 只能凸显现有的能力,不能突破预训练的边界,后训练 RLVR 的价值就有限了。
也有人认为 SFT 本质是一种特殊的 RL,这些或许都是值得思考的问题。但总体来说,目前主流的训练 follow pretrain → SFT → RL 的流程(也许?)
二、Agentic RL
Agentic RL 即在 Agent 训练过程中使用 RL 方法,由于 Agent 是一个黑箱,又需要与环境交互,RL 的训练就会比较有效。
一个简单的想法是拿着 Agent 的每一轮的 trajectory 做 RL训练。可是 Agent 和 一些经典游戏的差别是,游戏可以只有上下左右,只有很小的离散动作空间;而网页 Agent 的动作是 tool call,参数是连续的,因此增加了长轨迹的学习难度。下面以 OpenWebRL 为例简单介绍。
OpenWebRL 是面向视觉网页 Agent的在线多轮强化学习框架,训练 Agent 在真实浏览器环境中完成网页交互任务。
Pipeline
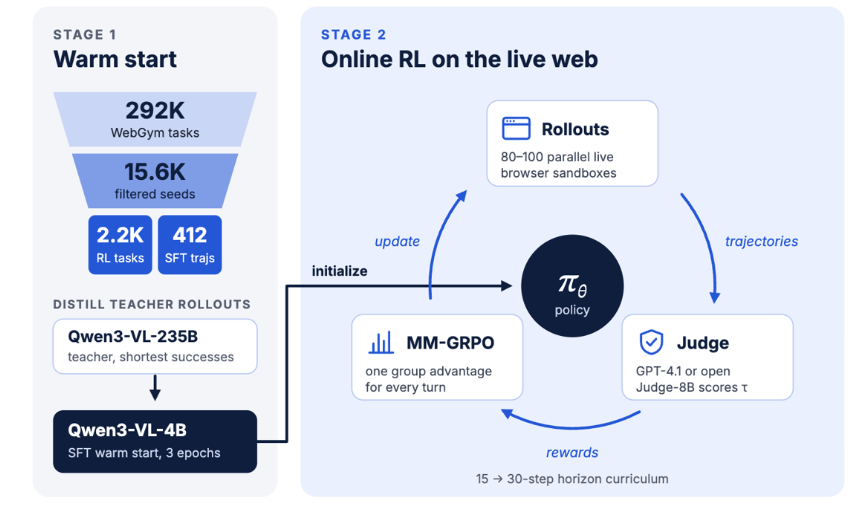
主要分成SFT 和 online RL:
- SFT:
- 使用强教师模型 Qwen3-VL-235B-A22B-Thinking 在网页任务上采样交互轨迹(teacher rollouts)
- 用这份数据微调 Qwen3-VL-4B-Thinking
- RL:
- 初始策略接入真实浏览器环境,采样多条完整 rollouts;
- Reward Judge:
- Format check:是否满足调用的 protocol。
- VLM Judge:读取任务指令、动作历史、最近 3 张网页截图,对整条轨迹做轨迹级评估
- MM-GRPO Update
- 更新 Policy,重新接入环境评测
- 初始策略接入真实浏览器环境,采样多条完整 rollouts;
Harness for Live Web
OpenWebRL 的一大改革点在于它是直接和在线的网页做交互。为了防止真实环境的波动,它搭建了一套 robust 的 live-web harness(Orchard Env),专门应对真实网页环境的各类噪声,例如 弹窗、页面跳转、网络瞬断、网站改版。分为以下三个模块:
- Isolated sandboxes(K8s):
- 每一条 rollout 单独分配一个 K8s 沙箱浏览器实例,会话、Cookie、页面状态完全隔离,任务之间不会互相污染;
- 对恶意 / 不稳定站点做黑名单,规避风险网站。
- Timeouts & retries: 分阶段设置超时和重试
- Failure attribution: 失败归因,分为 Model 侧的失败和网页环境的问题。如果是网页问题的错误,就不送入 RL 更新
MM-GRPO
为什么要 MM-GRPO, 分 turn 和 trajectory?
先回顾一下标准的 GRPO:
这里的 GRPO 一般不区分 turn,它直接把整条轨迹当成一长串 token,全部一起平均。这会导致所有 token 没有 turn 之分,都同样重要。那么长 turn token 多,它的梯度贡献大,话语权天然更强。因此,一些短 turn(往往是简洁的工具动作:click、type 等)token 少,梯度贡献被比较小,因此很难学到。
MM-GRPO 的设计
MM-GRPO 改成先在一个 turn 内部做 token 平均,再把各个 turn 的 loss 相加。可以观察下式的主要改动就是先对 turn 做了一次平均。
其中:
- i:第 i 条轨迹 \(\tau_i\)
- \(T_i\):轨迹 i 一共包含 \(T_i\) 个交互轮次(turn)
- t:第 t 个 turn
- k:该 turn 内的 token 下标
- \(m_{i,t,k}\in\{0,1\}\):token mask,仅 assistant 输出的 token(推理 + tool call)取 1,其余输入 token(图片、环境反馈、用户 prompt)mask 为 0
- \(\rho_{i,t,k} = \dfrac{\pi_\theta(a_{t,k}|s_{i,t})}{\pi_{\text{old}}(a_{t,k}|s_{i,t})}\):该 token 处新旧策略重要性比率
- \(A_i\):整条轨迹共享的轨迹优势(trajectory-level advantage,同一条轨迹所有 turn 共用同一个\(A_i\))
- \(\text{clip}(\rho_{i,t,k},\;1-\varepsilon_l,\;1+\varepsilon_h)\):非对称裁剪,选取 \(\varepsilon_l=0.20,\varepsilon_h=0.28\)。
- 这是因为对于网页 Agent 而言,成功案例比较稀缺,失败案例比较多,因此适当的调整一下,让负案例不要把策略删的那么厉害,正案例更激进一些。
我对这篇论文的评价
虽然我没怎么接触过 RL,不知道 RL 的 paper 通常是怎么组织的,但我不得不说这篇文章真的可读性有点差,翻遍这篇文章,全是字,而且连个 Pipeline 图都没有… 所以总体来说我觉得这并不是一篇接触 Agentic RL 比较好的 paper。虽然但是,这篇 paper 居然中了 nips 2026..
作为一篇 Note,我觉得还是要尊重主讲人的设计,因此我没有自作主张换一篇 paper。因此,我想总结以下这篇 paper 比较值得参考的几个点:
- 整体的 Pipeline,虽然他并没有给出流程图。
- Agentic RL 在生产环境(比如 Web Agent 情形下)可能会遇到的问题,以及它是怎么设计这个 Harness的
- MM-GRPO
另外还可以有一些小小的思考:
- 关于这个场景。目前推出 CLI 的应用软件越来越多,我们使用 VLM 来做这样的网页浏览 agent 任务到底是不是吃力不讨好呢?
- 作为一篇 中了nips 2026
(且排版一坨)的 paper,它到底做得好的地方在哪里呢?个人认为除了它对turn/trajectory做了处理,设计了MM-GRPO,另一个很重要的部分是场景,仔细读论文会发现这篇文章是在真实的网站上做的 RL,因此需要搭建一套 harness,而之前通常会用例如 WebArena 这样的环境。 - 目前的 Agentic RL 最难设计的点在哪里?个人认为可能就是和环境的交互,这也就是为什么我在第二点里认为这套 harness 可能是这篇文章贡献最大的地方
最后是对于选择入门的论文的思考,分享一些我的个人习惯,由于之前读 sida 老师科研经验 的缘故,我习惯建立所谓科研树,因此我觉得读 survey、寻找一些 milestone 甚至读别人写的博客通常是入手的比较舒服的方式。当然这只是我目前的感觉…或许每个人的学习方式也不一样。
其他 Loss 设计 - Tool-Verse / TARA
为了解决 turn/trajectory 所引入的、在 agentic RL 中的 Loss 设计问题,也有其他工作的一些解决方案,即 ToolVerse. 它主要做了下面两件事情:
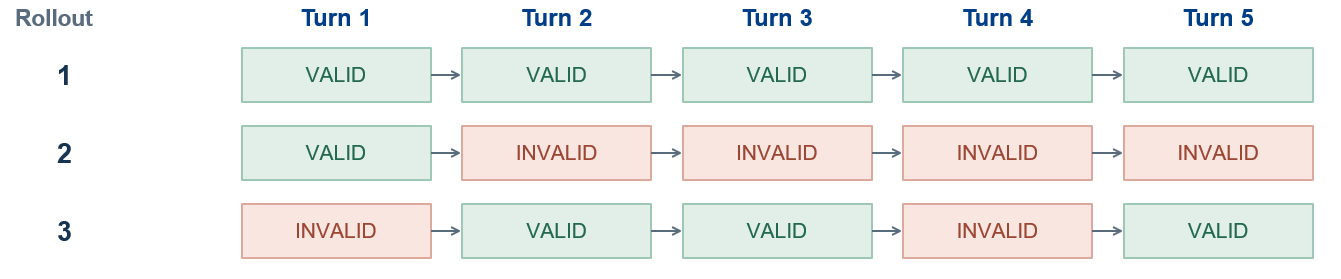
- 构建了一个可验证的工具环境,能在每一轮 turn 单独校验动作合法性,拿到 turn-level reward,每一个 turn 都有一个独立的 \(A_{i,t}\)
- 设计一个门控,如果本轮无效,直接切断后续未来收益。也就是说,其中一步是错的就是全错,不能蹭其他步骤的收益。例如下图中,Rollout 3 的所有 turn 都是不可以有收益的。
总结
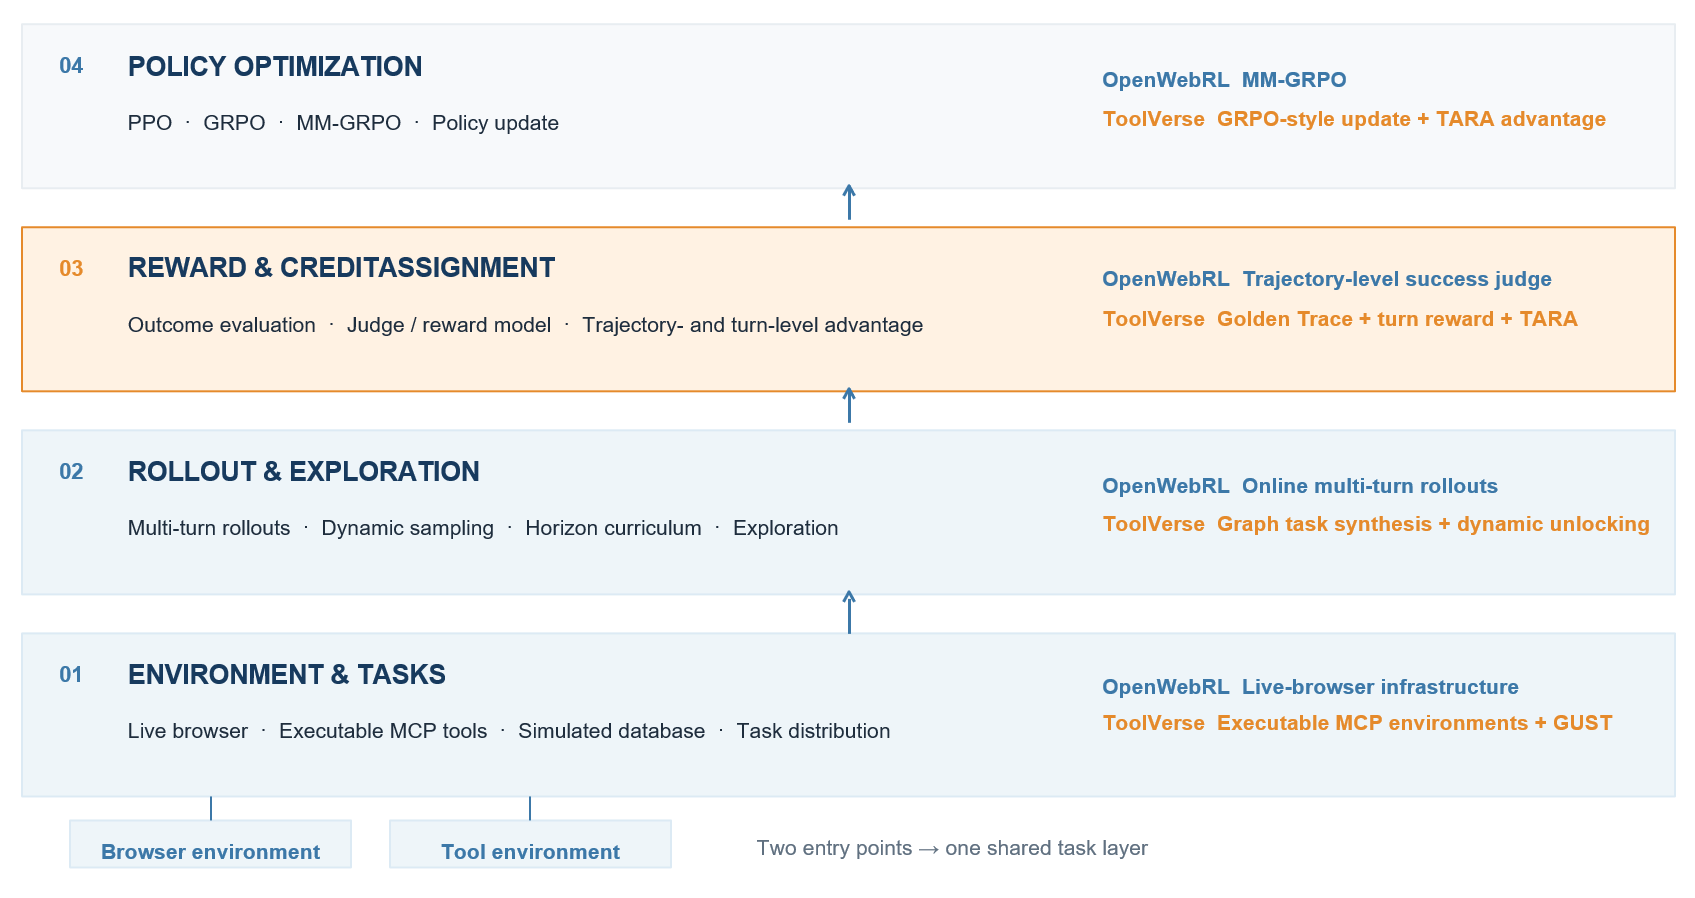
总的来说,对于一个RL问题,下面是一个通用的 Pipeline,如果他能够建模成一个 RL 问题,且 Environment 部分是比较好解决的,或许就可以用 RL 的方法做一个尝试。
References
- 强化学习的三条主线 https://lomuspg.github.io/reinforcement-learning.html
- 从传统RL的视角看大模型RLVR:算法篇 https://zhuanlan.zhihu.com/p/2005256302918665528
- 从零开始的verl框架解析 https://zhuanlan.zhihu.com/p/30876678559
- RLVR 到底是在学会推理,还是只是在更会抽样已有答案 https://zhuanlan.zhihu.com/p/2022105613044391938
- Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model? https://arxiv.org/abs/2504.13837
- RLVR 本质是一种 SFT? 为什么? https://www.zhihu.com/question/2050166250857411260/answer/2050167287068496340
- 为什么目前大模型的强化学习算法都是基于规则的Reward model? - tomsheep的回答 - 知乎 https://www.zhihu.com/question/1899253859144165159/answer/1925539747620720863
- OpenWebRL: Demystifying Online Multi-turn Reinforcement Learning for Visual Web Agents https://arxiv.org/pdf/2606.02031
- ToolVerse: Unlocking Massive Environments and Long-Horizon Tasks for Agentic Reinforcement Learning https://arxiv.org/abs/2607.15660