支持向量机
约 4181 个字 14 张图片 预计阅读时间 14 分钟
1. 线性可分(Linear Seperatable)
1.1 直观认识
二维:直线
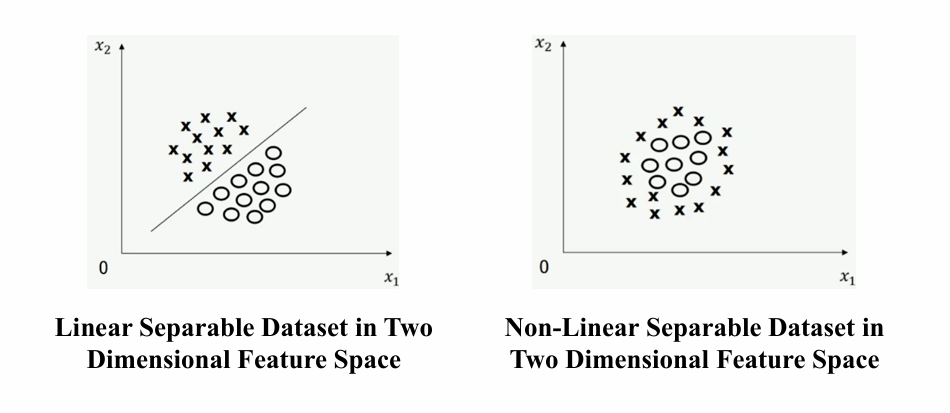
三维:平面
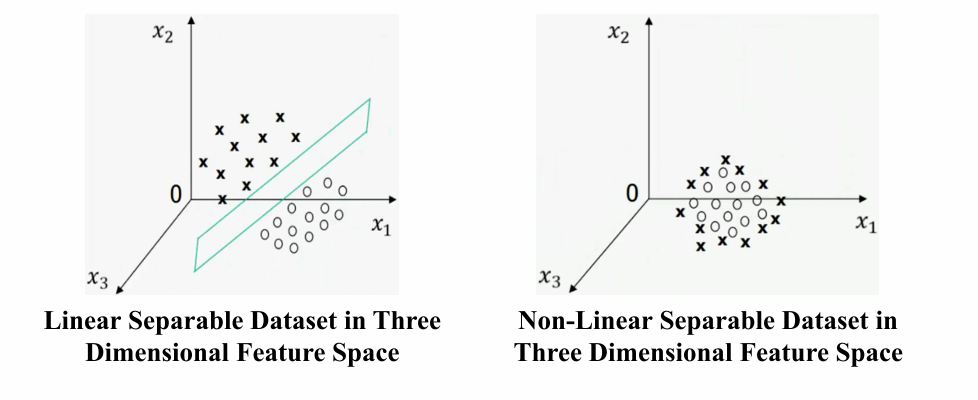
拓宽到三类:三种类别,两条直线;(我们主要研究二类,可以推广到多类)
1.2 数学表示
设直线:\(\omega_1 x_1 + \omega_2 x_2 + b =0\) , 其中,\(\omega\) 代表 weights(权重),\(b\) 代表 bias(偏置)
假设:
- circle side:\(\omega_1 x_1 + \omega_2 x_2 + b >0 \rightarrow C_1\) (class 1)
- cross side:\(\omega_1 x_1 + \omega_2 x_2 + b <0 \rightarrow C_2\) (class 2)
Explanation:为什么是假设?
- \(\omega_1 x_1 + \omega_2 x_2 + b =0 \rightarrow -\omega_1 x_1 - \omega_2 x_2 - b =0\)
- \(\omega_1 x_1 + \omega_2 x_2 + b >0 \rightarrow -\omega_1 x_1 - \omega_2 x_2 - b <0\)
- \(\Rightarrow\) 不等号的方向可以转换
1.3 数据和标签
定义
- 假如有数据 \(\vec{X_i}\),对应的标签为\(y_i\),我们通常表示为 \((x_i,y_i) |_{i=1 \dots N}\)。
- 这里的 \(\vec{X_i}\)是向量,\(\vec{X_i}=[x_1, x_2, \dots x_N]^{T}\),为已有数据。\(y_i\)就是标签
- 在二分类前提下,\(y_i=\{+1,-1\}\),即:
$$
y_i =
\begin{cases}
+1, & \text{if } x_i \in C_1 \
-1, & \text{if } x_i \in C_2
\end{cases}$$
- 支持向量机中,我们人为规定为\(\pm 1\)。三分类问题中,也可以将 \(y_i\) 定义为\(\{0,1,2\}\)。其他方法中还有独热编码等定义方式。
线性可分集的定义
定义1:
如果存在\((\omega, b)\),使得数据集\(\{(X_i, y_i)\}_{i=1\sim N}\)满足:
如果不存在满足上述条件的\((\omega, b)\),则数据集是 非线性可分 的。
注意:在\(d\)维特征空间中,\(X_i = \begin{bmatrix} x_{i1} \\ x_{i2} \\ \vdots \\ x_{id} \end{bmatrix}\)。我们定义权重向量\(\omega = \begin{bmatrix} \omega_1 \\ \omega_2 \\ \vdots \\ \omega_d \end{bmatrix}\)。所以我们有
Tip
由矩阵的相关知识,我们知道 \(\omega^T X_i + b\) 矩阵相乘的结果是一个标量,因此可以和0作比较。
定义2:
将上面的 if 统一成一个表达式
一个数据集 \(\{(X_i, y_i)\}_{i=1 \sim N}\) 是线性可分的,如果存在 \((\omega, b)\) 满足:
\(y_i(\omega^T X_i + b) > 0 (i = 1 \sim N)\)
如果不存在满足上述条件的 \((\omega, b)\),则该数据集是线性不可分的。
2. SVM 算法
2.1 几何解释
Question
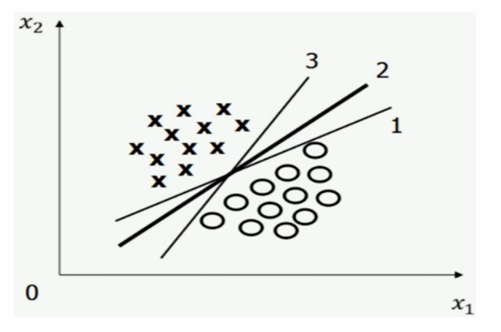
如果有一条直线可以分开两个集合,那么一定存在无数条直线能够将他们分开。那么,哪种是最优的呢?
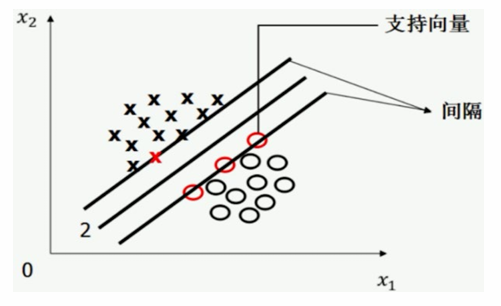
下面给出两组定义:
- 支持向量(Supporting Vector): 对于一条(超平面)将两个类别分开的线,上下移动它,那么它首先会经过一些向量。我们称这些向量为支持向量。
- 间隔(Margin):通过支持向量的两条线之间的距离。
SVM算法即寻找对于不同的向量而言,margin最大的那一组解。例如如下几组数据中,中间一组的margin是最大的。
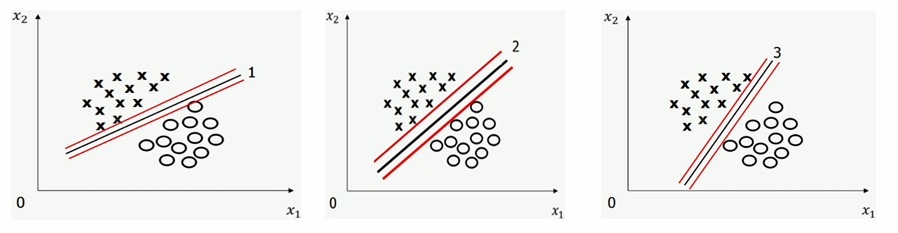
由上面的描述,我们可以得出情况2中的直线满足以下条件:
- 该直线区分了两组数据集(分割了 〇 和 × )
- 该直线的支持向量有 最大的margin
- 该直线刚好在这个区域的正中间(所有支持向量到这条直线的距离是一样的)
思考:为什么直线2在这组数据集里是唯一的呢?
证明思路:
- margin 是一个连续函数,一定存在一个最大值
- 最大化margin后,区域一定是两条平行红线的区域
- 由此,一定能选取中间的一条直线作为所求直线
2.2 表述为优化问题
其中:
- \(\{(X_i, y_i)\}_{i=1\sim N}\):训练数据及其对应的标签。(已知量)
- \((\omega, b)\):待确定的 变量。
- \(\frac{1}{2}\|\omega\|^2\):优化问题的 目标函数。
- \(y_i[\omega^T X_i + b] \geq 1 (i \in 1 \sim N)\):优化问题的 约束条件。
这里\(\|\omega\| = \sqrt{\omega_1^2 + \omega_2^2 + \cdots + \omega_d^2}\)是\(\omega\)的模,所以:
$$
\frac{1}{2}|\omega|^2 = \frac{1}{2}\sum_{i=1}^{d}\omega_i^2
$$
添加系数\(\frac{1}{2}\)的原因
方便求导\(||\omega||^2\)后系数归为1
公式解释
分析已知量及代求量?
- 已知:\((x_i,y_i), i = 1 \dots N\), 数据集及标签
- 代求:\(\vec{\omega}=[\omega_1,\omega_2, \dots, \omega_N]\)和\(b\)
事实1
当\(a>0\) 时,\(\omega^T X+b=0\) 与 \((a\omega)^T X+(ab)=0\) 等价。
Example
\(2x+3y+5=0\)和\(4x+6y+10=0\)表达的为同一直线。
\(\therefore y_i(\omega^T X_i + b)>0 \Leftrightarrow y_i[(a\omega^T) X_i + (ab)]>0 \quad (i=1 \sim N)\)
事实2
点到直线距离计算公式: \(d = \frac{\omega^T X_0 + b}{||\omega||}\)
若直线公式为:\(\omega_0 x+ \omega_1 y+b=0\),点 \((x_0, y_0)\),那么点到直线公式:
\(d=\frac{w_0 x+ w_1 y +b}{\sqrt{\omega^2_0+\omega^2_1}}\)
由上述两个事实,我们进行如下处理:
通过选择一个合适的缩放因子 \(a\),使得:
1. 对于所有的 支持向量 \(X\),\(|(\omega')^T X + b'| = 1\)。
2. 对于所有的 非支持向量 \(X\),\(|(\omega')^T X + b'| > 1\)。
(这么做的前提是,如果这个集合线性可分,对于任意斜率 \(k\), 一定有其中一条平行直线是过集合中的一个点的,缩放因子将以此为准。则如果这条直线远离恰好相切的支持向量,必然会有 \(|(\omega')^T X + b'| > 1\))
Example
-
初始超平面
假设有一个超平面,其参数为:
\(\omega = \begin{bmatrix} 3 \\ 2 \end{bmatrix}\) 和 \(b = 4\)
那么超平面的方程是:\(\omega^T X + b = 3x_1 + 2x_2 + 4 = 0\)。 -
选择一个支持向量
假设存在一个支持向量 \(X = \begin{bmatrix} 2 \\ 1 \end{bmatrix}\)。我们计算它代入方程左侧的绝对值:
\(|\omega^T X + b| = |3 \times 2 + 2 \times 1 + 4| = |6 + 2 + 4| = 12\) -
计算缩放因子并进行缩放
为了让这个值等于 1,我们需要将它除以 12。因此,我们选择缩放因子 \(a = \frac{1}{12}\)。
现在我们得到新的参数 \((\omega', b')\):
\((\omega', b') = (a\omega, ab) = (\frac{1}{12} \begin{bmatrix} 3 \\ 2 \end{bmatrix}, \frac{1}{12} \times 4) = (\begin{bmatrix} 1/4 \\ 1/6 \end{bmatrix}, \frac{1}{3})\) -
验证结果
我们将同一个支持向量 \(X\) 代入新的标准化方程中进行验证:
\(|(\omega')^T X + b'| = |\frac{1}{4} \times 2 + \frac{1}{6} \times 1 + \frac{1}{3}| = |\frac{1}{2} + \frac{1}{6} + \frac{2}{6}| = |\frac{3+1+2}{6}| = 1\)
结果正如我们所期望的,等于 1。
Tip
在最优超平面确定后,所有支持向量到该超平面的距离是相等的。因此,我们可以通过缩放参数,使得所有支持向量 \(X\) 都满足 \(|\omega^T X + b| = 1\)。
对于那些非支持向量,因为它们距离超平面更远,所以经过同样的缩放后,它们将满足 \(|\omega^T X + b| > 1\)。
在这样处理后,\(d=\frac{|\omega^T + b|}{||\omega||}=\frac{1}{||\omega||}, \therefore \text{maximize} \quad d \quad \Leftrightarrow \text{minimize} \quad ||\omega|| \quad\)
若记支持向量和数据集的相切点为A,则其他点一定远离这条支持向量和A点,因此其他点\(X_i\) 满足以下约束:
\(y_i[\omega^T X_i + b] \geq 1\)
2.3 凸函数
定义:
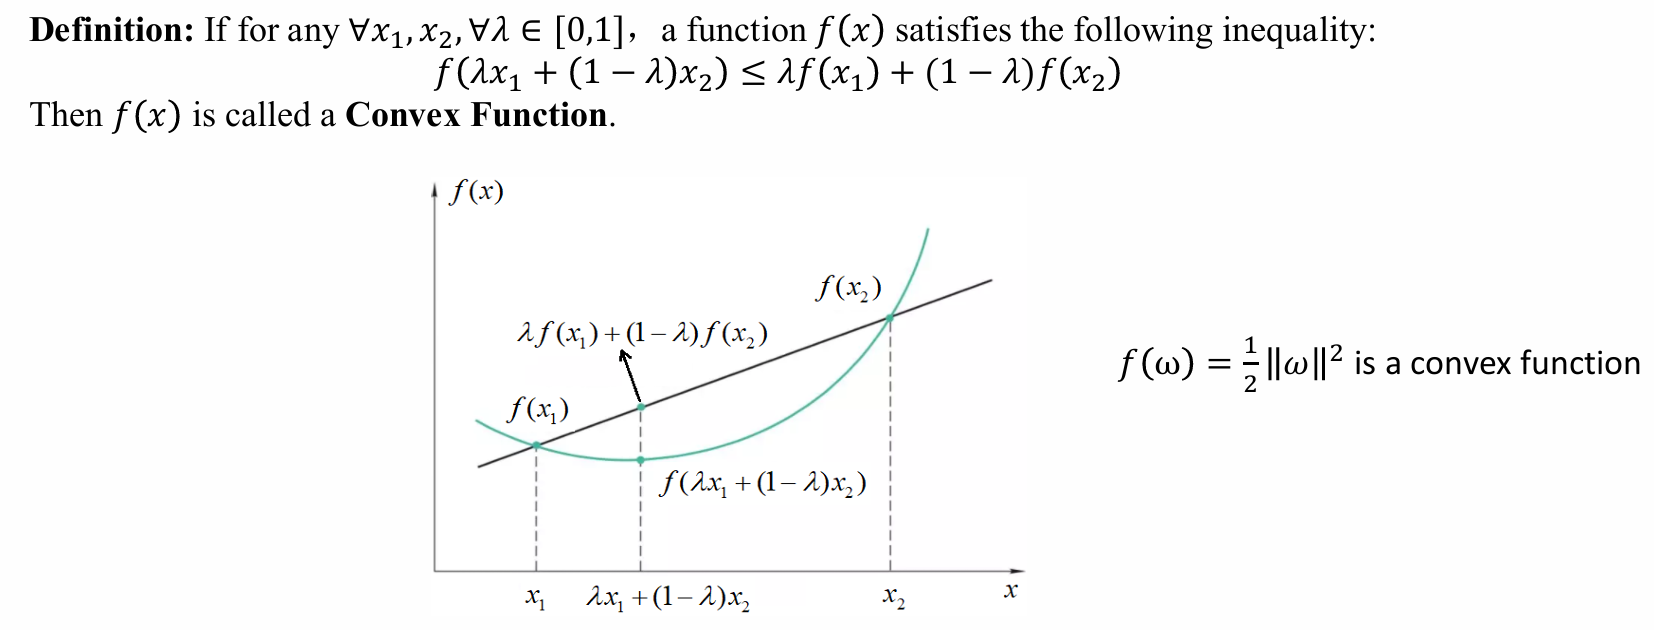
目标函数(object function)是凸函数;
限制条件:也是凸函数;
(要证,易证)
\(\Rightarrow\) 凸优化问题(目标函数、限制条件都为凸函数,则凸优化问题一定可以被解决)
- 二次规划问题:
- 目标函数是凸的二次函数
- 线性条件是一次函数
2.4 版本2:推广到非线性可分数据集
L1-SVM:
在先前的版本中,若沿用之前的规划,则找不到满足条件的\(\omega, b\)。
引入松弛变量:
- 当\(\delta_i \rightarrow \infty\) 时,一定满足第二条约束;
- \(\delta_i\) 变大时,解出的解没有意义。因此我们将他加入目标函数中,\(\delta_i\) 不会太大。
- \(C\):人为设定的数,\(C >0\)。\(C\) 设定的越大,说明我们越不想让 \(\delta\) 变大。
- \(C \sum_{i=1}^N \delta_i\):正则化项:若一个问题没有解/多于一个解/解的质量不好,\(\rightarrow\) 有解/唯一解/提升解的知量
这里的 \(C\) 为超参数。
同时,也有 L2-SVM:
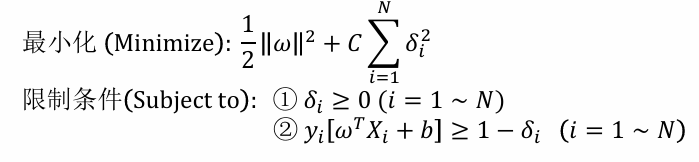
两者结果相似。
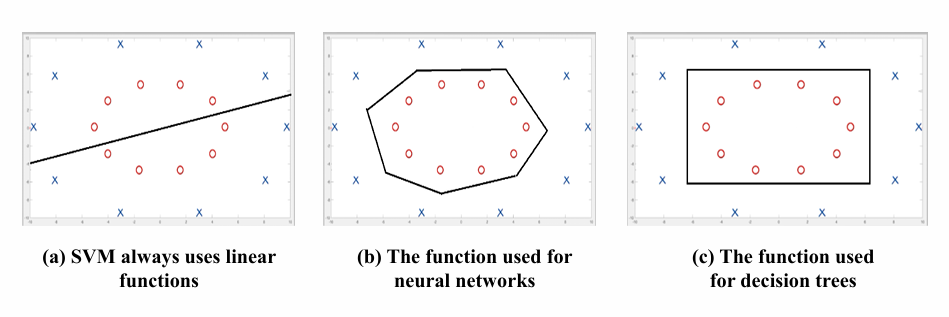
2.5 SVM 升维+线性处理
Example
最简单的线性可分问题:
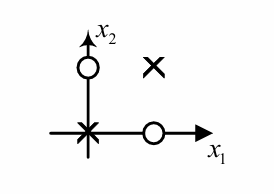
- 类别 \(C_1\):\(X_1 = \begin{bmatrix} 0 \\ 0 \end{bmatrix}\), \(X_2 = \begin{bmatrix} 1 \\ 1 \end{bmatrix}\)
- 类别 \(C_2\):\(X_3 = \begin{bmatrix} 1 \\ 0 \end{bmatrix}\), \(X_4 = \begin{bmatrix} 0 \\ 1 \end{bmatrix}\)
如果我们把这些点画在二维坐标系上,会发现没有任何一条直线能同时把 \((0,0), (1,1)\) 与 \((1,0), (0,1)\) 分开。
因此,我们设计了一个从二维到五维的映射函数 \(\varphi(X)\):
\(X = \begin{bmatrix} a \\ b \end{bmatrix} \rightarrow \varphi(X) = \begin{bmatrix} a^2 \\ b^2 \\ a \\ b \\ ab \end{bmatrix}\)
因此:
- 对于 \(X_1 = \begin{bmatrix} 0 \\ 0 \end{bmatrix}\)(属于 \(C_1\)):
\(\varphi(X_1) = \begin{bmatrix} 0^2 \\ 0^2 \\ 0 \\ 0 \\ 0 \times 0 \end{bmatrix} = \begin{bmatrix} 0 \\ 0 \\ 0 \\ 0 \\ 0 \end{bmatrix}\)
- 对于 \(X_2 = \begin{bmatrix} 1 \\ 1 \end{bmatrix}\)(属于 \(C_1\)):
\(\varphi(X_2) = \begin{bmatrix} 1^2 \\ 1^2 \\ 1 \\ 1 \\ 1 \times 1 \end{bmatrix} = \begin{bmatrix} 1 \\ 1 \\ 1 \\ 1 \\ 1 \end{bmatrix}\)
- 对于 \(X_3 = \begin{bmatrix} 1 \\ 0 \end{bmatrix}\)(属于 \(C_2\)):
\(\varphi(X_3) = \begin{bmatrix} 1^2 \\ 0^2 \\ 1 \\ 0 \\ 1 \times 0 \end{bmatrix} = \begin{bmatrix} 1 \\ 0 \\ 1 \\ 0 \\ 0 \end{bmatrix}\)
- 对于 \(X_4 = \begin{bmatrix} 0 \\ 1 \end{bmatrix}\)(属于 \(C_2\)):
\(\varphi(X_4) = \begin{bmatrix} 0^2 \\ 1^2 \\ 0 \\ 1 \\ 0 \times 1 \end{bmatrix} = \begin{bmatrix} 0 \\ 1 \\ 0 \\ 1 \\ 0 \end{bmatrix}\)
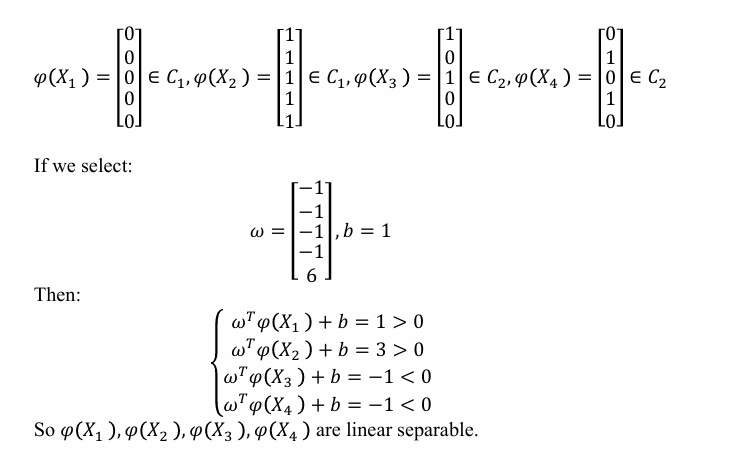
因此,原始的线性不可分数据点 \(\varphi(X_1), \varphi(X_2), \varphi(X_3), \varphi(X_4)\) 在新的五维特征空间中变得 线性可分 了。
一种取法:
高维空间线性可分性的定理
假设:
* 一个数据集包含 \(N\) 个样本。
* 每个样本都是从一个 \(d\) 维的特征空间中随机选取的。
* 每个样本被随机地赋予标签 \(+1\) 或 \(-1\)。
结论:
假设这些样本是线性可分的概率为 \(P(d, N)\),那么当特征空间的维度 \(d\) 趋向于无穷大时,这个概率会趋近于 1。
数学表达式为:
$$ \lim_{d \to +\infty} P(d, N) = 1 $$
SVM 表达式改写
其中 \(\omega\) 的维度与 \(X\) 的维度保持一致。
3. 核函数(Kernal Function)
3.1 定义
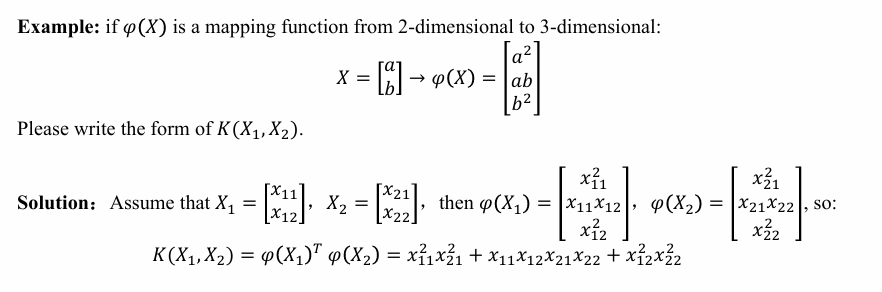
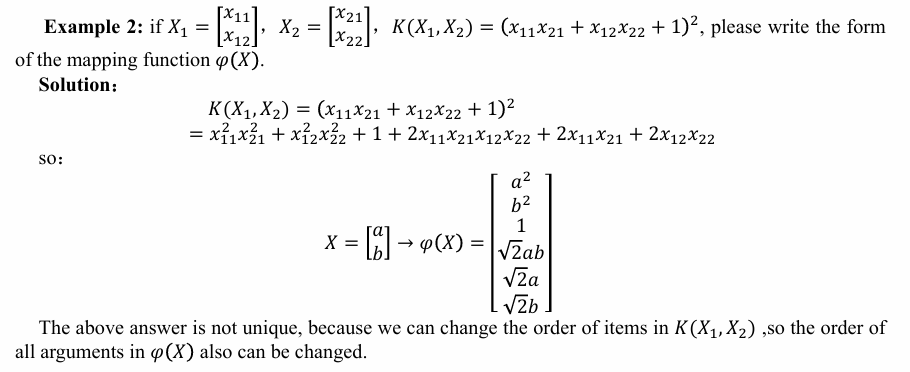
- Kernal Function: \(K(X_1, X_2)= \varphi(X_1)^T \varphi(X_2)\)
核函数计算
Especially:高斯核:
\(K(X_1,X_2)=e^{-\frac{||X_1-X_2||^2}{\sigma^2}}\)
- 其对应的 \(\varphi(X)\) 维度为无穷,较难直接写出(泰勒展开的维度是无穷的)
展开过程
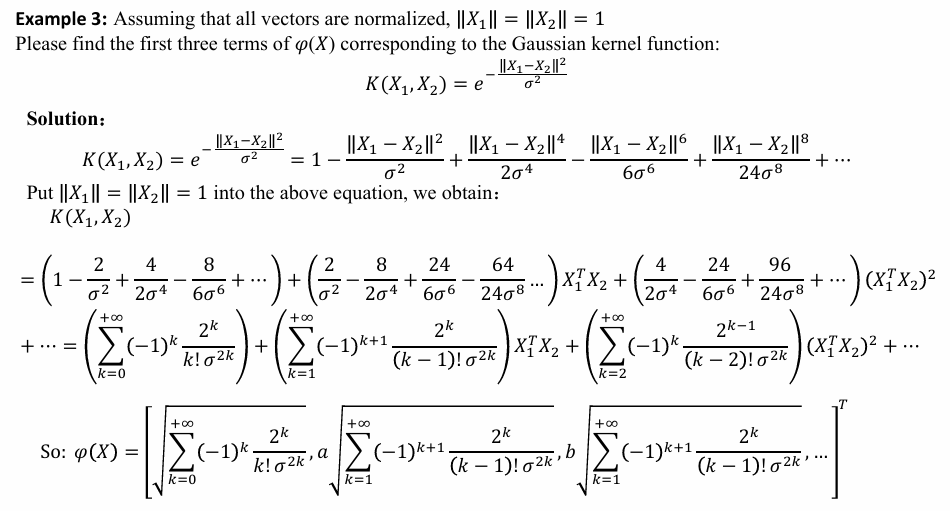
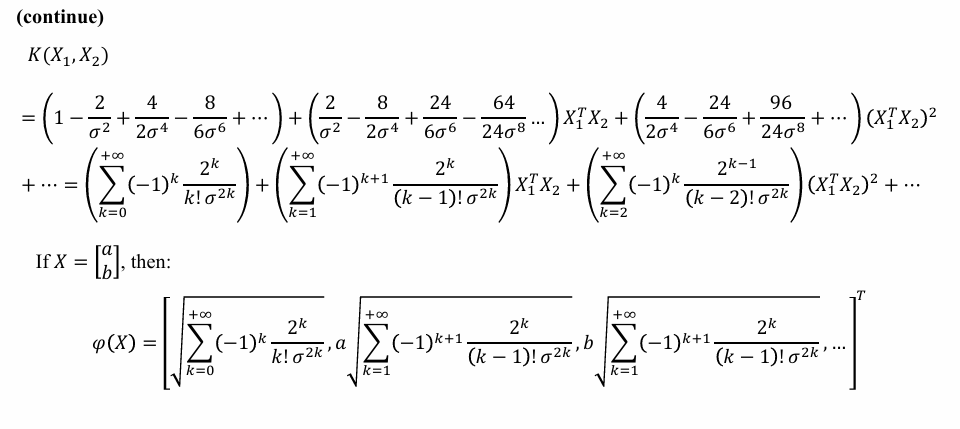
3.2 Mercer定理
Mercer定理 给出了一个函数 \(K(X_1, X_2)\) 能够被写成 \(\varphi(X_1)^T \varphi(X_2)\) 形式的充要条件:
一个函数 \(K(X_1, X_2)\) 是一个有效的核函数,必须满足以下两个条件:
1. 交换性(Commutativity)
函数必须是对称的,即交换输入参数的位置,函数值不变。
$$ K(X_1, X_2) = K(X_2, X_1) $$
这个条件是显而易见的,因为点积运算本身就满足交换律:\(\varphi(X_1)^T \varphi(X_2) = \varphi(X_2)^T \varphi(X_1)\)。
2. 半正定性(Semi-positive)
对于任意数量 \(N\) 的数据点 \(\{X_1, X_2, \dots, X_N\}\),以及任意一组实数 \(\{c_1, c_2, \dots, c_N\}\),以下不等式必须成立:
$$ \sum_{i=1}^{N} \sum_{j=1}^{N} c_i c_j K(X_i, X_j) \geq 0 $$
这个条件保证了由核函数构成的 核矩阵(Kernel Matrix 或 Gram Matrix) 是半正定的。 核矩阵 \(G\) 是一个 \(N \times N\) 的方阵,其中第 \(i\) 行 \(j\) 列的元素为 \(G_{ij} = K(X_i, X_j)\)。
这个半正定条件确保了核函数可以在某个希尔伯特空间(Hilbert Space)中被表示为内积,从而保证了SVM优化问题的凸性,使得求解全局最优解成为可能。
Mercer定理为我们筛选有效的核函数提供了理论依据。只要我们选择的函数满足对称性和半正定性,我们就可以放心地使用它作为核函数,来隐式地将数据映射到高维空间并进行计算,而无需关心具体的映射 \(\varphi\) 是什么。
3.3 引入 \(K(x_1, x_2)\) ,如何求解优化问题?
原问题(Prime Problem)
原问题几乎可以描述所有的优化问题(\(f(\omega), g(\omega), h(\omega)\) 可以取任意函数)。限制条件两组分别表示不等式和等式两种类型的约束,\(\leq\quad ,\quad \geq\)可以通过负号进行转换。
针对原问题设定对偶问题(Dual Problem)
定义:
- 定义拉格朗日函数 \(L(\omega, \alpha, \beta)\) 如下:
$$ L(\omega, \alpha, \beta) = f(\omega) + \sum_{i=1}^{K} \alpha_i g_i(\omega) + \sum_{i=1}^{M} \beta_i h_i(\omega) $$
* \(\omega\) 是原始优化问题的变量。
* \(\alpha = \{\alpha_1, \dots, \alpha_K\}\) 和 \(\beta = \{\beta_1, \dots, \beta_M\}\) 是拉格朗日乘数 (Lagrange multipliers)。
向量化表示:
$$ \mathbf{\alpha} = \begin{bmatrix} \alpha_1 \ \alpha_2 \ \vdots \ \alpha_K \end{bmatrix}, \quad \mathbf{g(\omega)} = \begin{bmatrix} g_1(\omega) \ g_2(\omega) \ \vdots \ g_K(\omega) \end{bmatrix} $$
- \(\sum_{i=1}^{K} \alpha_i g_i(\omega) = \mathbf{\alpha}^T \mathbf{g(\omega)}\)
- \(\sum_{i=1}^{M} \beta_i h_i(\omega) = \mathbf{\beta}^T \mathbf{h(\omega)}\)
对偶问题:
- 在优化理论中,每一个优化问题(称为 原始问题 Prime Problem 或 Primal Problem)都有一个与之对应的 对偶问题 (Dual Problem) (原问题的最优解在对偶问题中也成立)。对偶问题是基于 拉格朗日函数 \(L(\omega, \alpha, \beta)\) 来构建的。
定义:
$$
\begin{align}
\text{最大化(Maximize):} & \quad \theta(\alpha, \beta) = \inf_{\omega \in \Omega} L(\omega, \alpha, \beta) \
\text{限制条件(Subject to):} & \alpha_i \geq 0 \quad (i = 1 \sim K)
\end{align}
$$
其中, \(\inf_{\omega \in \Omega}\) 表示对所有在定义域 \(\Omega\) 内的变量 \(\omega\) 取下确界(固定此时的\(\alpha, \beta\))
。
(对于 \(\omega\) 最小,后对 \(\theta\) 最大)
Tip
第一步:构造对偶函数 \(\theta(\alpha, \beta)\)
- 我们首先写出拉格朗日函数 \(L(\omega, \alpha, \beta)\)。
- 然后,我们 固定 拉格朗日乘数 \((\alpha, \beta)\)。
- 接着,我们通过改变原始变量 \(\omega\),找到 \(L(\omega, \alpha, \beta)\) 的 最小值。
- 这个求出的最小值,就是对偶函数 \(\theta(\alpha, \beta)\) 在当前 \((\alpha, \beta)\) 处的函数值。所以,\(\theta(\alpha, \beta)\) 的结果是一个只与 \(\alpha\) 和 \(\beta\) 有关的表达式。
第二步:求解对偶问题
- 现在我们有了目标函数 \(\theta(\alpha, \beta)\)。
- 我们的任务是找到一组 \((\alpha, \beta)\),使得这个函数 \(\theta(\alpha, \beta)\) 被 最大化。
- 在寻找最大值的过程中,必须满足约束条件,即所有对应不等式约束的乘数 \(\alpha_i\) 都必须是 非负的 (\(\alpha_i \ge 0\))。
通过这个“先求最小,再求最大”的过程,我们将原始问题转化为了一个关于拉格朗日乘数的优化问题。
Proof
证明:
假设 \(x^*\) 是原始问题的一个可行解(即满足所有约束),并且 \(\alpha \ge 0\)。那么:
- \(f_i(x^*) \le 0\) 且 \(\alpha _i \ge 0\),所以 \(\sum \alpha _i f_i(x^*) \le 0\)。
- \(h_j(x^*) = 0\),所以 \(\sum \beta_j h_j(x^*) = 0\)。
\(\therefore \quad L(x^*, \alpha , \beta) = f_0(x^*) + \sum \alpha _i f_i(x^*) + \sum \beta_j h_j(x^*) \le f_0(x^*)\)
又由对偶函数的定义,\(g(\alpha , \beta) = \inf_x L(x, \alpha , \beta) \le L(x^*, \alpha , \beta)\)
结合以上两式,可得:
\(g(\alpha , \beta) \le f_0(x^*)\)
这对任何可行解 \(x^*\) 都成立,所以它也对最优解成立,即 \(g(\alpha , \beta) \le p^*\)。
对于对偶问题,还存在以下定理:
若\(\omega^*\)是原问题的解,\((\alpha^*, \beta^*)\)是对偶问题的解,那么有:
$\(f(\omega^*) \geq \theta(\alpha^*, \beta^*)\)$
Proof
证明:
(由定义)
对偶差距(Duality Gap)
\(G(\omega^*, \alpha^*, \beta^*) = f(\omega^*) - \theta(\alpha^*, \beta^*) \ge 0\)
好的,这是您图片内容的简体中文翻译,所有公式都用 $ 包裹:
强对偶定理
定理 (Strong Duality Theorem, 强对偶定理):
若 \(f(\omega)\) 是一个凸函数,并且 \(g(\omega), h(\omega)\) 是线性函数,即:
\(g(\omega) = A\omega + B, h(\omega) = C\omega + D,\)
则:\(f(\omega^*) = \theta(\alpha^*, \beta^*)\)
(或对偶间隙为零:\(G(\omega^*, \alpha^*, \beta^*) = f(\omega^*) - \theta(\alpha^*, \beta^*) = 0\))
KKT条件
定理:
如果强对偶定理成立,即
\(f(\omega^*) = \theta(\alpha^*, \beta^*)\),那么:对于所有的 ,必须满足 \(\alpha_i^* = 0\)或 \(g_i(\omega^*) = 0\)
Proof
卡罗需-库恩-塔克 (K.K.T) 条件: 如果强对偶定理成立,即
\(f(\omega^*) = \theta(\alpha^*, \beta^*)\)
回顾一下:
$$\begin{align}\theta(\alpha, \beta) &= \inf_{\omega \in \Omega} L(\omega, \alpha, \beta) \leq L(\omega^, \alpha^, \beta^)\&=f(\omega^)+(\alpha^)^Tg(\omega^)+\beta(\omega^)h(\omega^) \le f(\omega^)
\
&(g(\omega^)\leq 0,\quad h(\omega^*) = 0)
\end{align} $$
如果上述等式链成立(即首尾相等),那么我们必须有:
(1) \(\inf_{\omega \in \Omega} L(\omega, \alpha^*, \beta^*) = L(\omega^*, \alpha^*, \beta^*)\)
(2) \(f(\omega^*) + (\alpha^*)^T g(\omega^*) + (\beta^*)^T h(\omega^*) = f(\omega^*)\)
第一个等式意味着 \(L(\omega, \alpha^*, \beta^*)\) 在 \(\omega = \omega^*\) 时取得其最小值。对于第二个等式,由于我们有:
\(\alpha_i^* \ge 0 \quad (i=1 \sim K), \quad h_i(\omega^*) = 0 \quad (i=1 \sim M)\)
那么我们必须有:
对于所有的 \(i = 1 \sim K\),必须满足 \(\alpha_i^* = 0\) 或 \(g_i(\omega^*) = 0\)
以上就是 K.K.T 条件。